Коротко. robots.txt это текстовый файл в корне сайта. Он говорит поисковым роботам, какие адреса можно обходить, а какие нет. Это не защита и не удаление из индекса: файл ограничивает обход, но не скрывает страницу от поиска, если на неё ведут ссылки.
Как читать материал. В каждом разделе два пути: сделать руками и инструментами или подключить нейросеть, которая ускоряет разбор. Третий пункт: проверка. Нейросеть не знает, какие URL реально существуют на сайте, поэтому результат проверяем в браузере, через `curl` и панели вебмастера.
Что такое robots.txt
robots.txt лежит по адресу https://example.com/robots.txt. Внутри находятся правила для роботов: какой user-agent, какие пути закрыть, какие открыть, где находится sitemap.
Файл нужен, чтобы:
- не отдавать роботам служебные разделы;
- ограничить обход поиска, корзины, фильтров и дублей;
- указать sitemap;
- управлять доступом AI-краулеров.
Файл не нужен, чтобы:
- защитить админку паролем;
- убрать страницу из индекса;
- скрыть текст от пользователей;
- заменить canonical или noindex.
Что robots.txt умеет и не умеет
| Задача | robots.txt | Что использовать |
|---|---|---|
| Запретить обход раздела | Да, Disallow |
— |
| Убрать страницу из индекса | Нет | noindex, удаление, 410 или 301 |
| Скрыть админку | Нет | Авторизация и ограничение доступа |
| Указать sitemap | Да, Sitemap |
— |
| Управлять AI-краулерами | Да, отдельные группы | Политика доступа и проверка |
| Заменить canonical | Нет | rel="canonical" |
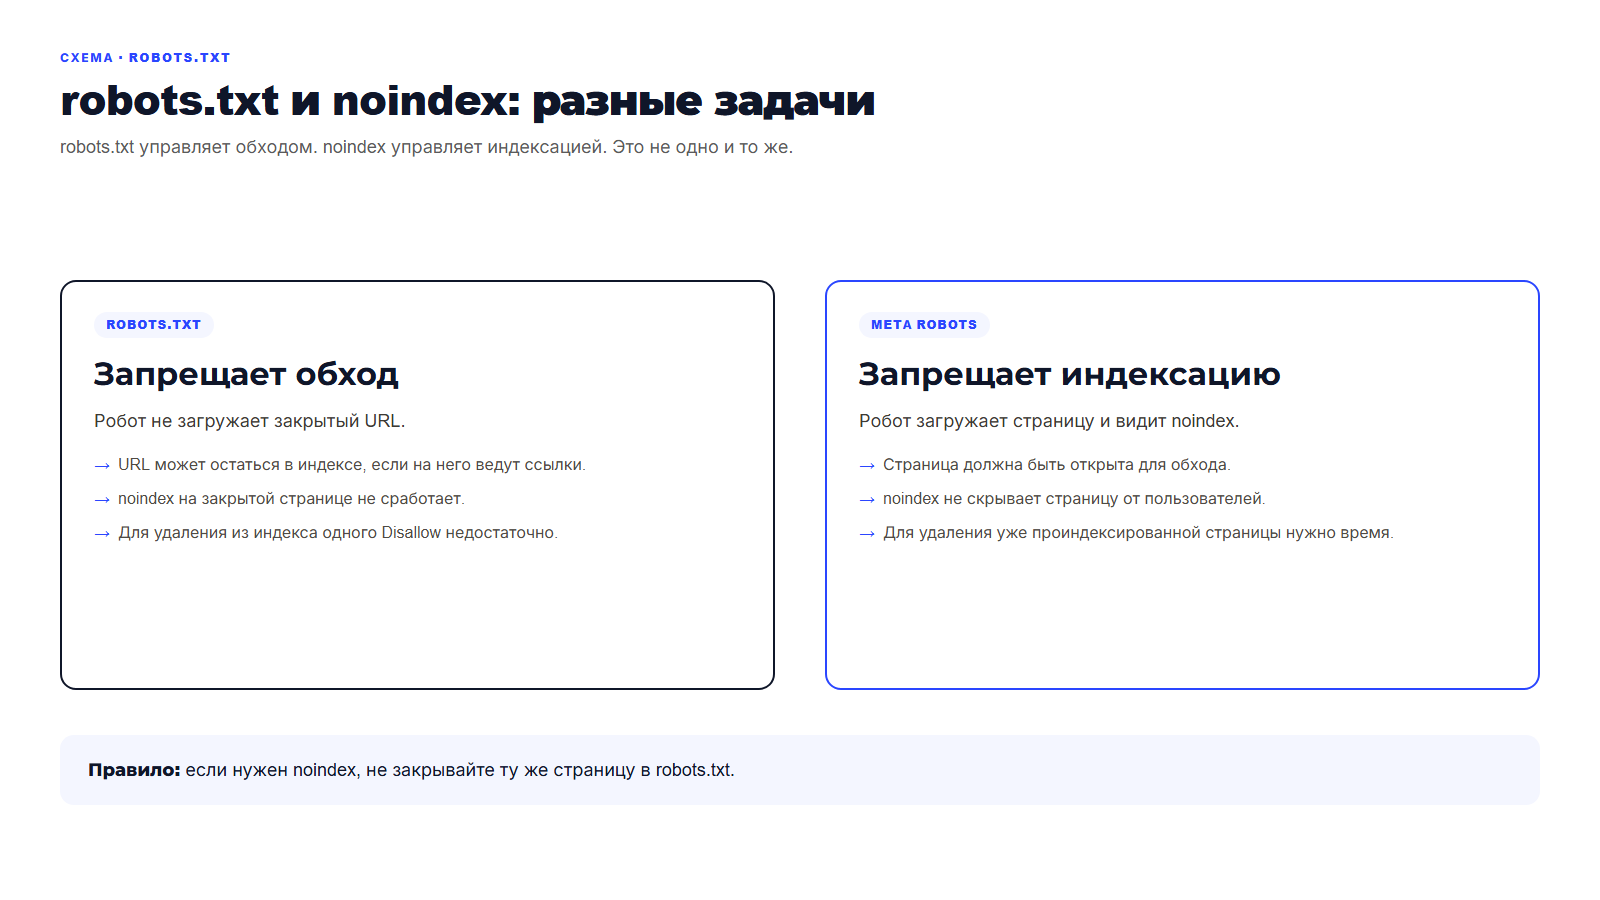
Главное: если страница закрыта в robots.txt, робот может не увидеть её noindex. Поэтому «закрыть в robots и поставить noindex» часто означает, что noindex не сработает.
Где лежит файл
- Только в корне домена:
/robots.txt. - Для каждого поддомена свой файл.
- Для
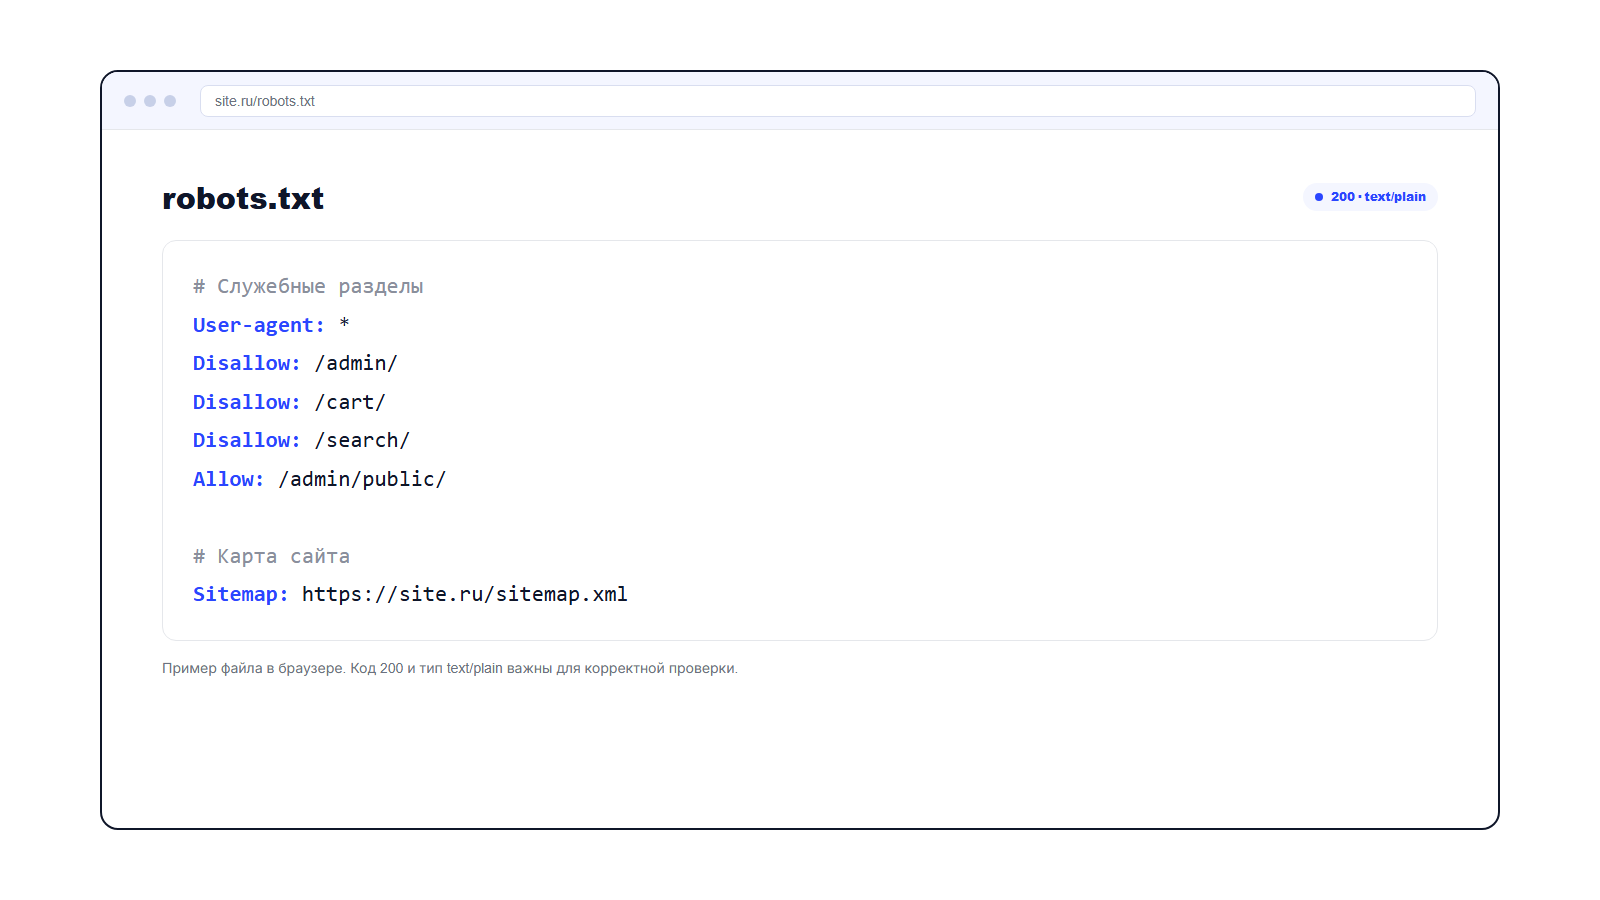
httpиhttpsпроверяется отдельно, но современный сайт должен жить на HTTPS. - Файл должен отдавать код 200 и тип
text/plain. - Кодировка UTF-8, без BOM.
- Имя файла строчными буквами.
Если файл отдаёт 404, робот считает, что ограничений нет. Если 5xx, обход может замедлиться или остановиться. Это важно проверять после деплоя и смены сервера.
Синтаксис
| Директива | Что делает | Пример |
|---|---|---|
User-agent |
Для какого робота правило | User-agent: * |
Disallow |
Закрывает путь | Disallow: /admin/ |
Allow |
Открывает путь | Allow: /admin/public/ |
Sitemap |
Указывает карту сайта | Sitemap: https://example.com/sitemap.xml |
Clean-param |
Убирает параметры для Яндекса | Clean-param: utm_source&utm_medium |
Crawl-delay |
Задержка обхода для Яндекса | Crawl-delay: 1 |
Комментарии начинаются с #. Пустой Disallow: означает «можно всё». Disallow: / закрывает весь сайт.
Основные поисковики поддерживают * и $ в путях, но детали лучше сверять с документацией конкретного робота.
Базовые шаблоны
Открытый сайт
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Закрыть служебные разделы
User-agent: *
Disallow: /admin/
Disallow: /cart/
Disallow: /search/
Allow: /admin/public/

Sitemap: https://example.com/sitemap.xml
Закрыть staging от индексации
User-agent: *
Disallow: /
Это временная мера для тестового домена. На production такой файл закрывает сайт целиком.
Отдельные правила для AI-краулеров
User-agent: GPTBot
Disallow: /

User-agent: *
Disallow:
Перед блокировкой решите, хотите ли вы исчезнуть из ответов конкретного AI-сервиса. Это не «SEO-выключатель», а политика доступа.
Яндекс и Google: что учитывать
Оба поисковика понимают User-agent, Disallow, Allow и Sitemap. Дальше начинаются различия:
- Яндекс поддерживает
Clean-paramиCrawl-delay. - Google не использует
Clean-paramиCrawl-delay. - У Google и Яндекса могут отличаться правила приоритета
AllowиDisallow. - Для удаления из индекса используйте
noindexили удаление страницы, а не только robots.txt.
Не копируйте файл с чужого сайта. Проверяйте его под свою структуру и текущую документацию.
robots.txt и sitemap
Директива Sitemap помогает роботу найти карту сайта. Она не заменяет саму карту и не гарантирует индексацию страниц.
Проверьте:
- sitemap доступен по HTTPS;
- в карте нет закрытых и несуществующих URL;
- файл robots.txt не блокирует sitemap;
- после обновления карты робот может её прочитать.
Если sitemap закрыт в robots.txt, поиск может не узнать о новых страницах.
Параметры URL и дубли
robots.txt не заменяет canonical. Если один товар открывается с разными параметрами, блокировка всех query-параметров может скрыть полезные страницы.
Для Яндекса можно использовать Clean-param, но Google эту директиву не поддерживает. Для Google и остальных роботов используйте canonical и нормализацию URL.
Не закрывайте параметры «на всякий случай». Сначала посмотрите, какие параметры действительно создают дубли.
Если сайт уже закрыт
- Откройте
https://example.com/robots.txt. - Найдите
Disallow: /или лишние запреты. - Верните корректный файл и сохраните бэкап.
- Проверьте, что файл отдаёт 200 и
text/plain. - Запросите переобход важных страниц в Яндекс Вебмастере и Google Search Console.
- Следите за статусом индексации несколько дней.
Не ждите, пока робот сам заметит ошибку. Чем дольше сайт закрыт, тем дольше восстанавливается обход.
Частые ошибки
Disallow: /на production. Сайт закрыт целиком.- Блокировка CSS и JS, которые нужны Google для рендеринга.
- Попытка убрать страницу из индекса через robots.txt.
noindexна странице, закрытой в robots.txt.- Файл лежит не в корне или на другом поддомене.
- robots.txt отдаёт 5xx или 404.
- BOM или неверная кодировка.
- Блокировка sitemap и служебных URL без проверки.
- Случайная блокировка поисковых и AI-роботов после копирования шаблона.
- Отсутствие проверки после деплоя.
Как проверить
- Откройте
https://example.com/robots.txtв браузере. - Проверьте код и тип ответа:
curl -I https://example.com/robots.txt- Убедитесь, что код 200, а не 404 или 5xx.
- Проверьте файл в Яндекс Вебмастере и Google Search Console.
- Посмотрите, какие URL закрыты, и нет ли среди них нужных страниц.
- Проверьте, что sitemap доступен и указан.
- После деплоя повторите проверку.
Классический путь. Прочитайте файл и сверьте правила с документацией.
curl -s https://example.com/robots.txtС нейросетью. Попросите проверить файл на конфликты.
Вот robots.txt сайта. Найди конфликты: закрытые важные разделы,
noindex на закрытых страницах, блокировку CSS/JS, ошибки синтаксиса.
Не придумывай URL, которых нет в файле. Предложи исправленный вариант.
Проверка. Проверьте каждый важный URL в панели вебмастера и через curl. Нейросеть не знает реальную структуру сайта.
Разбор проекта
Проверим сайт за вас
Посмотрим robots.txt, индексацию и технические ошибки, скажем, что исправлять первым. 20–30 минут в Zoom, Telegram или по телефону. Бесплатно.
Разобрать проектrobots.txt и AI-поиск
AI-краулеры имеют свои user-agent. Если вы хотите, чтобы материал мог попадать в ответы AI-сервисов, не блокируйте их случайно. Если не хотите, добавьте отдельную группу и проверьте, как это влияет на видимость.
llms.txt не заменяет robots.txt. Это другой формат, который не управляет обходом. Для доступа роботов используйте robots.txt и документацию конкретного сервиса.
Что отправить специалисту
- URL сайта и ссылку на robots.txt.
- Код ответа файла.
- Список важных разделов, которые должны оставаться открытыми.
- Список разделов, которые нужно закрыть.
- Есть ли поддомены и staging.
- Какие AI-краулеры нужно пускать или блокировать.
- Что уже проверяли в Вебмастере и Search Console.
Вопросы
robots.txt убирает страницу из индекса?
Нет. Он ограничивает обход. Для удаления из индекса нужен noindex, удаление страницы, 410 или 301.
Можно ли закрыть весь сайт через robots.txt?
Технически да, Disallow: /. Но на production это ошибка: сайт перестанет обходиться. Используйте только для staging.
Почему noindex не сработал?
Возможно, страница закрыта в robots.txt. Робот не загрузил её и не увидел noindex.
Нужен ли robots.txt, если есть sitemap?
Да. Это разные файлы: robots.txt управляет обходом, sitemap помогает найти страницы.
Где проверить файл?
В Яндекс Вебмастере, Google Search Console и через curl. После деплоя проверяйте снова.
Может ли нейросеть написать robots.txt?
Может предложить шаблон, но не знает вашу структуру. Проверяйте каждый путь и тестируйте файл.
Связанные материалы
- Ошибка 404: что значит и как исправить
- Ошибка 500: как найти причину
- Ошибка 503: почему сервер недоступен
Источники
Официальные документы 7
- Яндекс Вебмастер: robots.txtyandex.ru
- Яндекс Вебмастер: meta-robotsyandex.ru
- Google: Introduction to robots.txtdevelopers.google.com
- Google: robots.txt specificationdevelopers.google.com
- RFC 9309rfc-editor.org
- Google: обзор роботовdevelopers.google.com
- OpenAI: ботыplatform.openai.com