Коротко. Noindex запрещает поисковику добавлять страницу в индекс. Он не скрывает страницу от пользователей и не заменяет robots.txt, 301 или удаление.
Как читать материал. В каждом разделе два пути: сделать руками и инструментами или подключить нейросеть, которая ускоряет разбор. Третий пункт: проверка. Нейросеть не видит заголовки ответа и не знает, какие страницы уже в индексе, поэтому результат проверяем в коде, через curl и в панелях вебмастера.
Что такое noindex
Noindex — директива для робота: страницу можно обойти, но не нужно добавлять в индекс.
Основные способы:
<meta name="robots" content="noindex, follow">Для не-HTML файлов:
X-Robots-Tag: noindexfollow разрешает переходить по ссылкам со страницы. nofollow запрещает. Для большинства случаев достаточно noindex, follow.
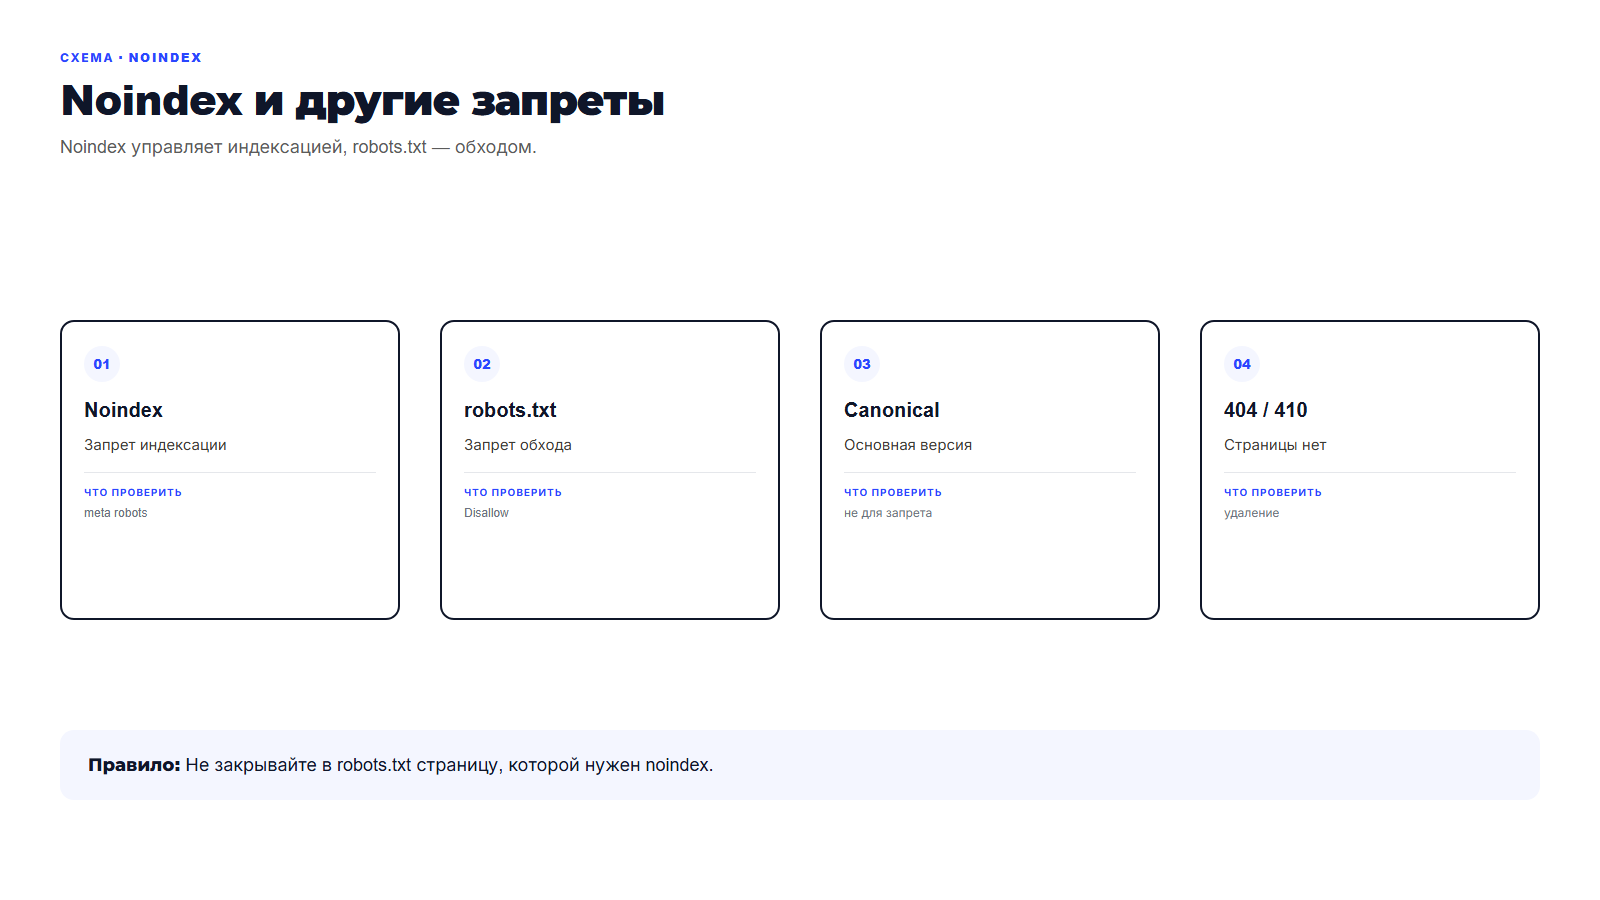
Noindex, robots.txt, canonical и 404
| Инструмент | Что делает | Когда использовать |
|---|---|---|
| Noindex | Запрещает индексацию | Страница доступна, но не нужна в поиске |
| robots.txt | Ограничивает обход | Служебные разделы, которые не нужно обходить |
| Canonical | Указывает основную версию | Дубли с доступными URL |
| 404 | Ресурс не найден | Страницы нет |
| 410 | Ресурс удалён навсегда | Страница снята окончательно |
Главное правило: если нужен noindex, не закрывайте ту же страницу в robots.txt. Робот не загрузит её и не увидит директиву.
Когда нужен noindex
- Внутренний поиск и результаты фильтров.
- Тонкие страницы без ценности.
- Тестовые и служебные разделы.
- Дубли, которые должны остаться доступными.
- Персональные страницы.
- Страницы с временным контентом.
Когда noindex не нужен
- Важные страницы, которые должны приводить трафик.
- Страницы, которые переехали. Здесь нужен 301.
- Удалённые страницы. Здесь 404 или 410.
- Страницы, закрытые в robots.txt.
- Страницы, которые уже должны быть в индексе.
Как проверить
- Откройте исходный код страницы и найдите
<meta name="robots">. - Проверьте заголовки:
curl -I https://example.com/page/- Для PDF и других файлов ищите
X-Robots-Tag. - Проверьте страницу в Google Search Console и Яндекс Вебмастере.
- Убедитесь, что страница не закрыта в robots.txt.
- Помните: удаление из индекса занимает время.
Классический путь. Соберите список URL и проверьте meta robots и заголовки.
С нейросетью. Дайте таблицу URL и директив.
Вот список URL и их meta robots. Найди конфликты: noindex на важных страницах,
noindex вместе с robots.txt, noindex на canonical, страницы без директивы.
Не придумывай URL. Для каждого пункта напиши проверку.
Проверка. Откройте каждый URL, проверьте код ответа, meta robots и заголовки.
Разбор проекта
Проверим сайт за вас
Посмотрим индексацию, noindex и robots.txt, скажем, что исправлять первым. 20–30 минут в Zoom, Telegram или по телефону. Бесплатно.
Разобрать проектЧастые ошибки
- Ставить noindex на важные страницы.
- Закрывать ту же страницу в robots.txt.
- Ждать мгновенного удаления из индекса.
- Ставить noindex и canonical одновременно без понимания.
- Закрывать noindex страницы, которые должны приводить трафик.
- Не проверять заголовки для PDF и файлов.
- Путать noindex с nofollow.
Вопросы
Noindex убирает страницу из индекса сразу?
Нет. Поисковику нужно время, чтобы обойти страницу и обновить индекс. Для срочного удаления используют другие инструменты.
Чем noindex отличается от robots.txt?
Noindex запрещает индексацию. robots.txt ограничивает обход. Если страница закрыта в robots.txt, робот может не увидеть noindex.
Можно ли ставить noindex и canonical вместе?
Обычно это конфликт. Если страница не должна быть в индексе, canonical ей не нужен.
Нужен ли noindex для 404?
Нет. Код 404 уже сообщает, что страницы нет. Noindex не нужен.
Может ли нейросеть проверить noindex?
Она может разложить список URL, но не видит заголовки и индекс. Проверяйте через curl и панели вебмастера.
Связанные материалы
Источники
Официальные документы 5
- Google: блокировка индексированияdevelopers.google.com
- Яндекс Вебмастер: запрет индексированияyandex.ru
- Яндекс Вебмастер: meta-robotsyandex.ru
- MDN: meta robotsdeveloper.mozilla.org
- Google: удаление информацииdevelopers.google.com